[情報] 先讀 trace 再寫 eval:Arize 示範的 judge 把 13 份報告全判錯,換成 faithfulness 才分出 6 份可靠、7 份不可靠
適合已經做出 agent、但還靠「看起來不錯」決定上線的工程師和 PM。講者 Laurie Voss 是 Arize 的開發者關係負責人、npm 共同創辦人;這是 AI Engineer World's Fair 的兩小時入門工作坊,示範工具是 Arize 自家的 AX,觀念本身不綁工具。〔0:00〕
- 跑三次覺得不錯就上線,等於沒有測試
- 三種 eval 各有漏洞,要疊起來用
- agent 會每一步都做對、最後卻整個錯,也會用你沒想到的方法做對
- 寫第一個 eval 之前,先把 trace 一份份讀完
- 能用幾行程式檢查的,就不要請 LLM 來判
- judge 要拿到 agent 看過的資料,不然只是在比誰的訓練資料新
- 自訂 rubric 要寫可觀察的條件,一個 evaluator 只看一件事
- judge 也是分類器,要拿人工標註驗它
- 把失敗的 trace 存成資料集,讓 coding agent 依 judge 的理由改 prompt,再用實驗證明
- 上線後抽樣跑 online eval,每個新失敗都變成下一輪的回歸測試
- 明天就能做的事
- 資料來源
一、跑三次覺得不錯就上線,等於沒有測試
多數 AI 功能是這樣上線的:做好、跑幾個查詢、看起來對就出貨。Voss 說,跑三次不是測試集。〔9:09〕
傳統單元測試在這裡不管用,因為同一個 prompt 每次輸出都不一樣,兩個不同答案可能都對,沒有固定字串可以比。改靠人看,又沒辦法放大,也抓不到回歸,更進不了 CI。〔9:30〕
他舉兩個沒有 eval 就做不到的事:改 system prompt 修語氣,結果 bot 開始亂編產品功能,要等使用者回報才知道;換新模型,要手動測好幾週。有 eval 的話,跑一遍分數就能在幾小時內比出來。〔9:55〕 〔10:40〕
他對 trace 和 eval 的定義很短:trace 是 AI 的 log,記下每次 agent、工具和 LLM 呼叫的輸入輸出;eval 是 AI 的測試。〔7:40〕 〔8:05〕
二、三種 eval 各有漏洞,要疊起來用
| 種類 | 適合 | 弱點 |
|---|---|---|
| code eval | 格式、長度、禁用詞、必填欄位這類有標準答案的檢查;毫秒級、免費、每次結果一樣 〔11:21〕 | 跟老式單元測試一樣容易太死 〔11:55〕 |
| LLM 當 judge | 事實對不對、有沒有忠於來源、語氣對不對這類要懂意思的問題 〔12:10〕 | 要花錢、自己也不穩定,要拿人工判斷校正 〔12:50〕 |
| 人工評估 | 品質的黃金標準,也適合處理沒見過的失敗 〔13:10〕 | 慢又貴;他引述人工標註員因為疲勞會漏掉多達 50% 的缺陷 〔13:20〕 |
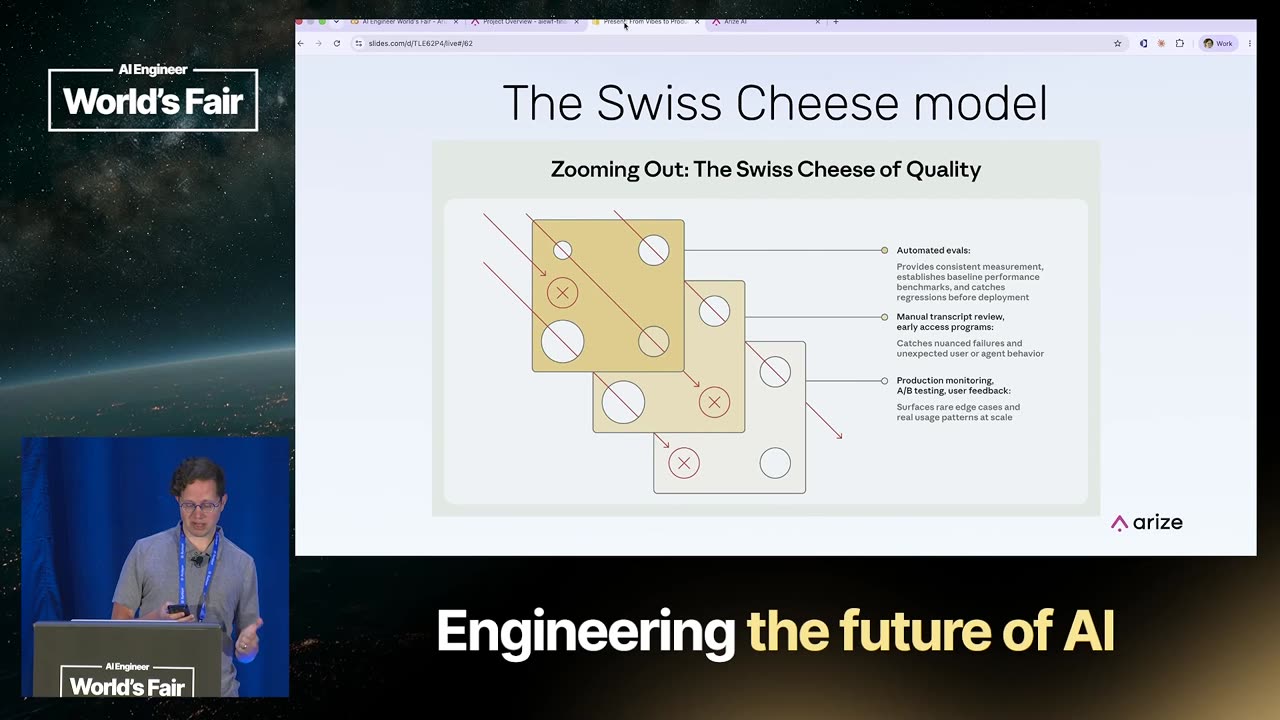
他借安全工程的瑞士起司模型:每片起司都有洞,疊夠多片,洞就不會對齊。code eval 抓格式、judge 抓推理缺口、人抓細微問題,合起來才有覆蓋率。〔48:30〕
三、agent 會每一步都做對、最後卻整個錯,也會用你沒想到的方法做對
agent 每多一次工具呼叫和決策,出錯機會就多一點,所以中間步驟也要評:工具選對沒、參數對不對、知不知道何時停。卡在迴圈是真實會發生的失敗。〔14:27〕 〔15:00〕
他的例子:問特斯拉這家車廠,agent 搜到的卻是 18 世紀發明家特斯拉,寫出一份排版漂亮的發明家報告交給老闆。每一步都照指令做,沒有單元測試抓得到。〔15:40〕 〔16:00〕
反過來也會發生。他提到 Anthropic 跑 τ²-bench 時,出題者以為經濟艙機票不能改期,agent 卻依政策先升等頭等艙再改期,結果被判失敗。〔16:20〕
所以他建議評 agent 交出來的結果,不評它走的路徑。硬檢查「先叫這個工具再叫那個」會懲罰合理的新做法。〔57:20〕 〔58:00〕
- 檢查最終輸出和最終狀態,不要把工具呼叫順序寫死在測試裡。
四、寫第一個 eval 之前,先把 trace 一份份讀完
Voss 說這是整場最重要的一件事:讀十幾份以上的 trace,從頭讀到尾,專挑出錯的。沒搞懂失敗就自動化,做出來的 eval 只會量好量的東西。〔38:54〕 〔39:10〕
示範用的是 Claude Agent SDK 寫的財報分析 agent,跑了 13 次。表面上多數報告都不錯,讀 trace 才發現 3 份把報告寫進 Colab 根本沒有的硬碟,輸出只剩「已存檔」;Microsoft 那份一直搜尋停不下來;Rivian 那份對資料很少的公司寫得很篤定。〔42:50〕 〔43:20〕 〔43:50〕 〔44:50〕
讀的方法來自質性研究:先做 open coding,每份 trace 用自然語言記下看到的問題;再做 axial coding,把相似的歸成類別,並追問根本原因,例如搜尋結果不好、推理錯、編數字、超出範圍。修哪個先看頻率乘嚴重度,一百次裡有一次教人做炸彈,就算少見也先修。〔45:30〕 〔46:40〕 〔47:50〕
讀之前還要先寫下什麼叫好。他列的成功條件:提到正確代號、有近期可用的財務數字、有可執行的建議、分清前瞻分析和歷史整理。這些定義多半在 PM、QA、客服手上,要找他們一起寫。〔40:00〕 〔40:40〕
- 先把成功條件寫成清單,找懂業務的同事一起定。
- 讀 trace 時先自由記錄問題,讀完再歸類,依頻率和嚴重度排修正順序。
五、能用幾行程式檢查的,就不要請 LLM 來判
第一個 eval 只檢查報告有沒有提到要分析的股票代號,幾行 Python 就做完,不用模型也不用 API。〔49:16〕 〔56:30〕
結果 12 份通過、1 份失敗:問 AWS 獲利的那份從頭到尾只談 AWS,完全沒提 Amazon 的代號。〔54:00〕 〔54:50〕
code eval 也不一定只做字串比對。只要同樣輸入永遠給同樣答案,就可以查資料庫,或打 API 拿真實股價核對有沒有亂編。〔57:00〕
- 先寫一個最便宜的 code eval,檢查你最在意、能用程式判斷的那一點。
六、judge 要拿到 agent 看過的資料,不然只是在比誰的訓練資料新
他先用內建的 correctness eval,judge 用 Sonnet 4.6,比做事的 Haiku 強。結果 13 份全拿 0 分。〔1:00:00〕 〔1:01:00〕
原因是 correctness 拿 judge 自己的知識當標準,而 agent 是即時上網查 2026 年的財報;judge 的知識停在更早,只能抱怨報告寫了它不可能知道的事。〔1:01:10〕 〔1:02:00〕
改用 faithfulness,把 agent 第一輪研究抓到的資料一起交給 judge,問報告有沒有忠於這些資料。結果 6 份忠實、7 份不忠實,約一半在編來源裡沒有的東西。這才是能往上爬的 capability eval。〔1:02:11〕 〔1:04:00〕
差別不在哪個 eval 比較好,在你的使用情境。〔1:05:00〕
同樣是內建 eval,在不查網路的應用裡 correctness 可能就很好用。先問清楚你在問什麼問題。〔1:05:20〕
- agent 會查即時資料時,把查到的內容當 context 交給 judge,改評忠實度。
- judge 用比 agent 更強的模型。
七、自訂 rubric 要寫可觀察的條件,一個 evaluator 只看一件事
沒有內建 eval 會檢查「建議能不能照著做」,所以要自己寫 actionability rubric。他建議四件事:說清楚 judge 在看什麼、列出明確的通過和不通過條件、用 XML 標籤包住輸入和輸出、在 prompt 外設定輸出選項。他另外會放好壞範例,但承認業界對這點有爭議。〔1:06:25〕 〔1:06:50〕 〔1:07:00〕
「好的回答要有幫助且正確」不是條件。要寫成人看了能回答是或否的東西,例如「有具體建議」「有前瞻分析,不只歷史數字」,而且每條都對應讀 trace 時看到的失敗。〔1:07:40〕 〔1:08:10〕
標籤用二元最好。1 到 5 分 LLM 分不清 3 和 4。也請 judge 先說理由再給分,準確度會提高,理由也能拿來修程式。〔1:12:00〕 〔1:13:00〕
不要寫一個什麼都檢查的「神 evaluator」,判失敗時你不知道是哪一項。rubric 裡列了六件事,就該拆成六個 evaluator。也要分清哪些是擋出貨的護欄、哪些是北極星指標:護欄退步要半夜叫人,北極星下滑看週報就好。〔1:18:00〕 〔1:19:00〕
- 把 rubric 條件改寫成能回答是或否的句子,輸出改成二元標籤。
- 一個 rubric 檢查超過一件事就拆開。
- eval prompt 跟程式一樣做版本控管。
八、judge 也是分類器,要拿人工標註驗它
LLM judge 輸入一份報告、預測可不可執行,所以可以像分類器一樣拿人工判斷當標準答案來量。Arize AX(Arize 的觀測與評估平台)讓非工程同事在介面上逐筆標註,標完的欄位會跟著匯出。〔1:20:00〕 〔1:21:00〕 〔1:22:50〕
示範的一致率是 46%,13 筆裡 6 筆相同,但他先說了,人工標籤是他隨機點的,目的是製造分歧。真實情況要逐筆讀 judge 的理由,判斷是 rubric 寫得模糊還是人標錯,再把條件寫緊。〔1:25:00〕 〔1:25:40〕
標註資料可以 75% 拿來調 rubric、25% 留著驗證,避免 judge 只學會你那一批。多數情況先顧 recall,寧可多抓幾個誤判,也不要放過真的錯。〔1:24:30〕 〔1:27:00〕
要提防的偏差有位置、長度、語氣篤定和偏愛自己產出的內容,所以最好用另一家的模型來當 judge。人跟人的評分一致度常只有 0.2 到 0.3,judge 偶爾跟你不同不代表不能信,一直不同才是警訊。〔1:27:30〕 〔1:28:30〕 〔1:29:00〕
- 挑一批 trace 人工標註,比對 judge 的判斷,逐筆讀不一致的理由。
- judge 和 agent 盡量用不同家的模型。
九、把失敗的 trace 存成資料集,讓 coding agent 依 judge 的理由改 prompt,再用實驗證明
改完 prompt 再跑幾個例子看看,又回到靠感覺。他的做法是把失敗的 trace 篩出來存成資料集,通過的另存一份當回歸測試。〔1:30:27〕 〔1:31:00〕
接著讓 Claude 讀這些失敗的解釋,連同需求一起,重寫研究和撰寫兩個 prompt。每個改動都追得到某一則失敗理由。之後在同一份資料集、同一組 evaluator 上跑實驗,只換 prompt,分數差異才能歸給這次改動。示範從約一半錯變成全對,他直說真實情況不會這麼順。〔1:33:00〕 〔1:36:00〕 〔1:37:00〕 〔1:38:00〕
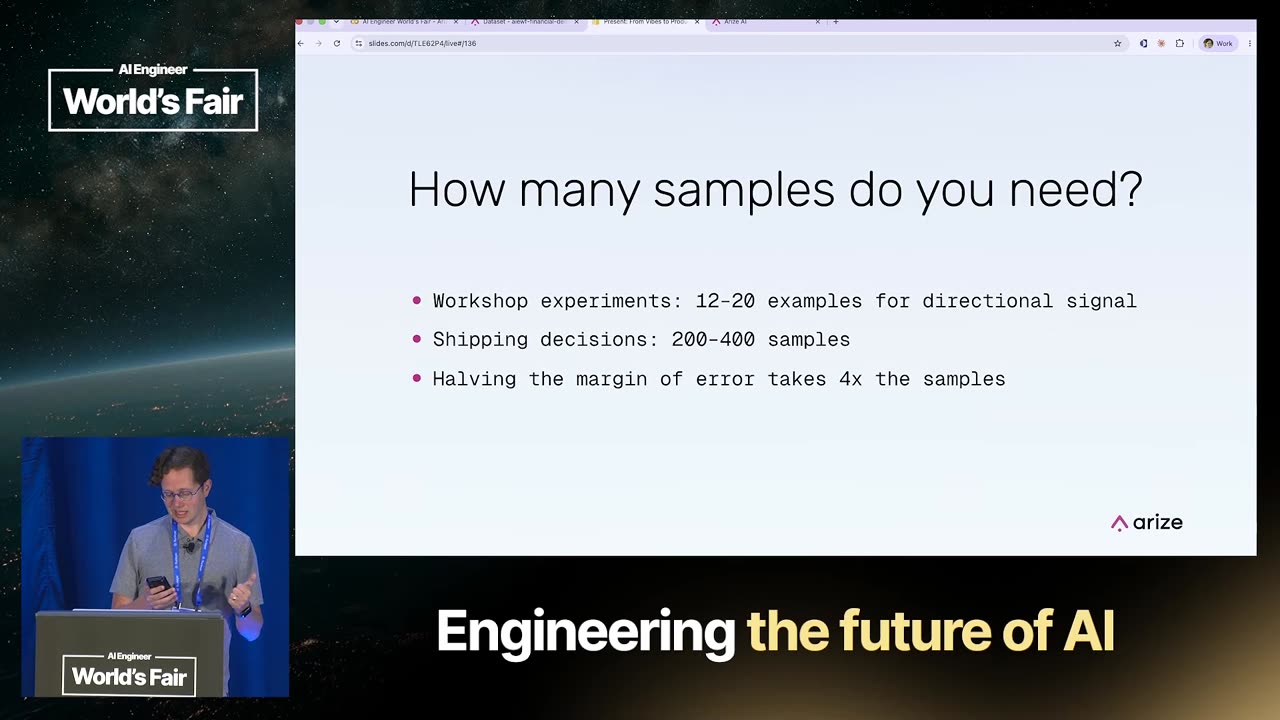
樣本數:工作坊規模 12 到 20 筆只能看方向,真的要決定出貨抓 200 到 400 筆。誤差減半要四倍樣本。〔1:39:40〕 〔1:40:00〕
投入順序:先修資料品質,再改 prompt,再換模型;temperature、top p 這類參數最後才動。〔1:40:20〕 〔1:41:00〕
- 失敗和通過的 trace 各存一份資料集,每次改動都在同一份上比。
- 改進順序照資料、prompt、模型、參數。
十、上線後抽樣跑 online eval,每個新失敗都變成下一輪的回歸測試
開發時的 evaluator 可以直接拿去自動評正式流量,用 span 或整條 trace 當範圍。LLM judge 要錢,抽 10% 或 1% 就有方向。〔1:43:00〕 〔1:43:50〕
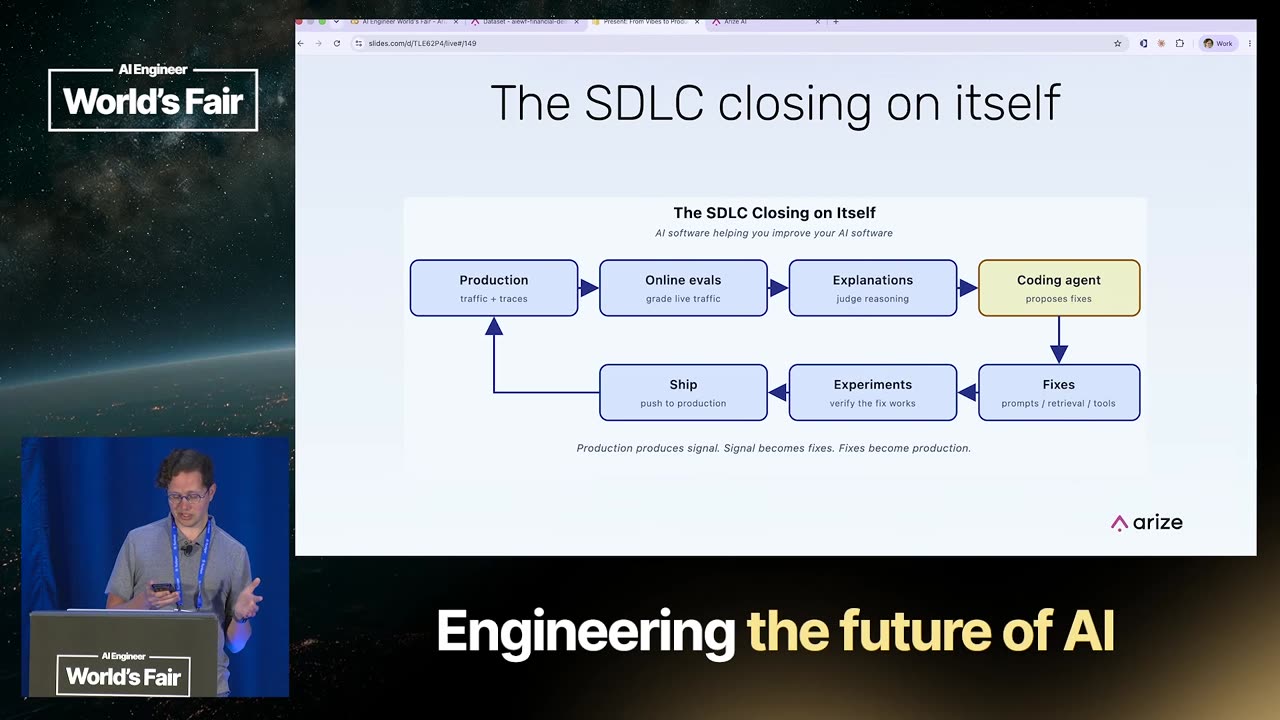
整個循環是:正式流量產生 trace,online eval 打分並寫理由,coding agent 讀理由提出修正,實驗驗證後出貨,新流量再被同一套 eval 評一次。抓到的每個失敗存進資料集,累積成只有你有的資料。〔1:45:00〕 〔1:48:00〕
交給 coding agent 時他提兩道護欄:一起給需求,別只叫它讓 eval 通過,不然它會把測試資料塞進程式作弊;叫它找共同主題,不要一個失敗寫一段修補。〔1:47:00〕
- 正式環境先抽一小部分流量跑 online eval。
- 叫 coding agent 修 eval 失敗時,附上需求並要求它先歸納共同原因。
明天就能做的事
- 把 trace 接上(Arize 的說法是兩行程式),先讀 15 分鐘真實輸出。
- 找懂業務的同事寫下什麼叫好,變成可回答是或否的條件。
- 讀 trace 時先自由記錄問題,再歸類,依頻率乘嚴重度排順序。
- 先寫一個最便宜的 code eval。
- agent 會查即時資料時,用 faithfulness 並把查到的內容給 judge。
- rubric 一次只檢查一件事,輸出用二元標籤。
- 人工標註一批資料,量 judge 跟人的一致度。
- 失敗和通過的 trace 各存一份資料集,改動後在同一份上跑實驗。
- 正式環境抽樣跑 online eval,新失敗存成回歸測試。
資料來源
- From Vibes to Production: Evaluating and Shipping AI Agents That Work 101 — Laurie Voss, Arize AI(原始影片)|AI Engineer(YouTube)|2026
- Arize-ai/arize-skills|Arize AI(GitHub)|影片說明附的連結
- seldo.com|Laurie Voss|影片說明附的連結
※ 使用者提供的是影片檔,依畫面和長度(1:51:26)找到 AI Engineer 頻道上的原片。逐字稿以 Whisper(medium.en)轉寫影片原音,並對照原片的 en-orig 字幕校正。圖片截自原片。〔時間〕連結開啟原片對應段落,大多對到分鐘。50% 漏檢、0.2–0.3 一致度、200–400 筆等數字是講者口述,沒有另外查證;τ²-bench 的例子也依講者轉述。示範的 46% 一致率來自刻意亂標的人工標籤。本文為非官方整理,以原影片為準。