[情報] 別把組織圖做成 agent:Anthropic 建議把 subagent 收回一個主迴圈,有客戶跑起來快了約 2 倍
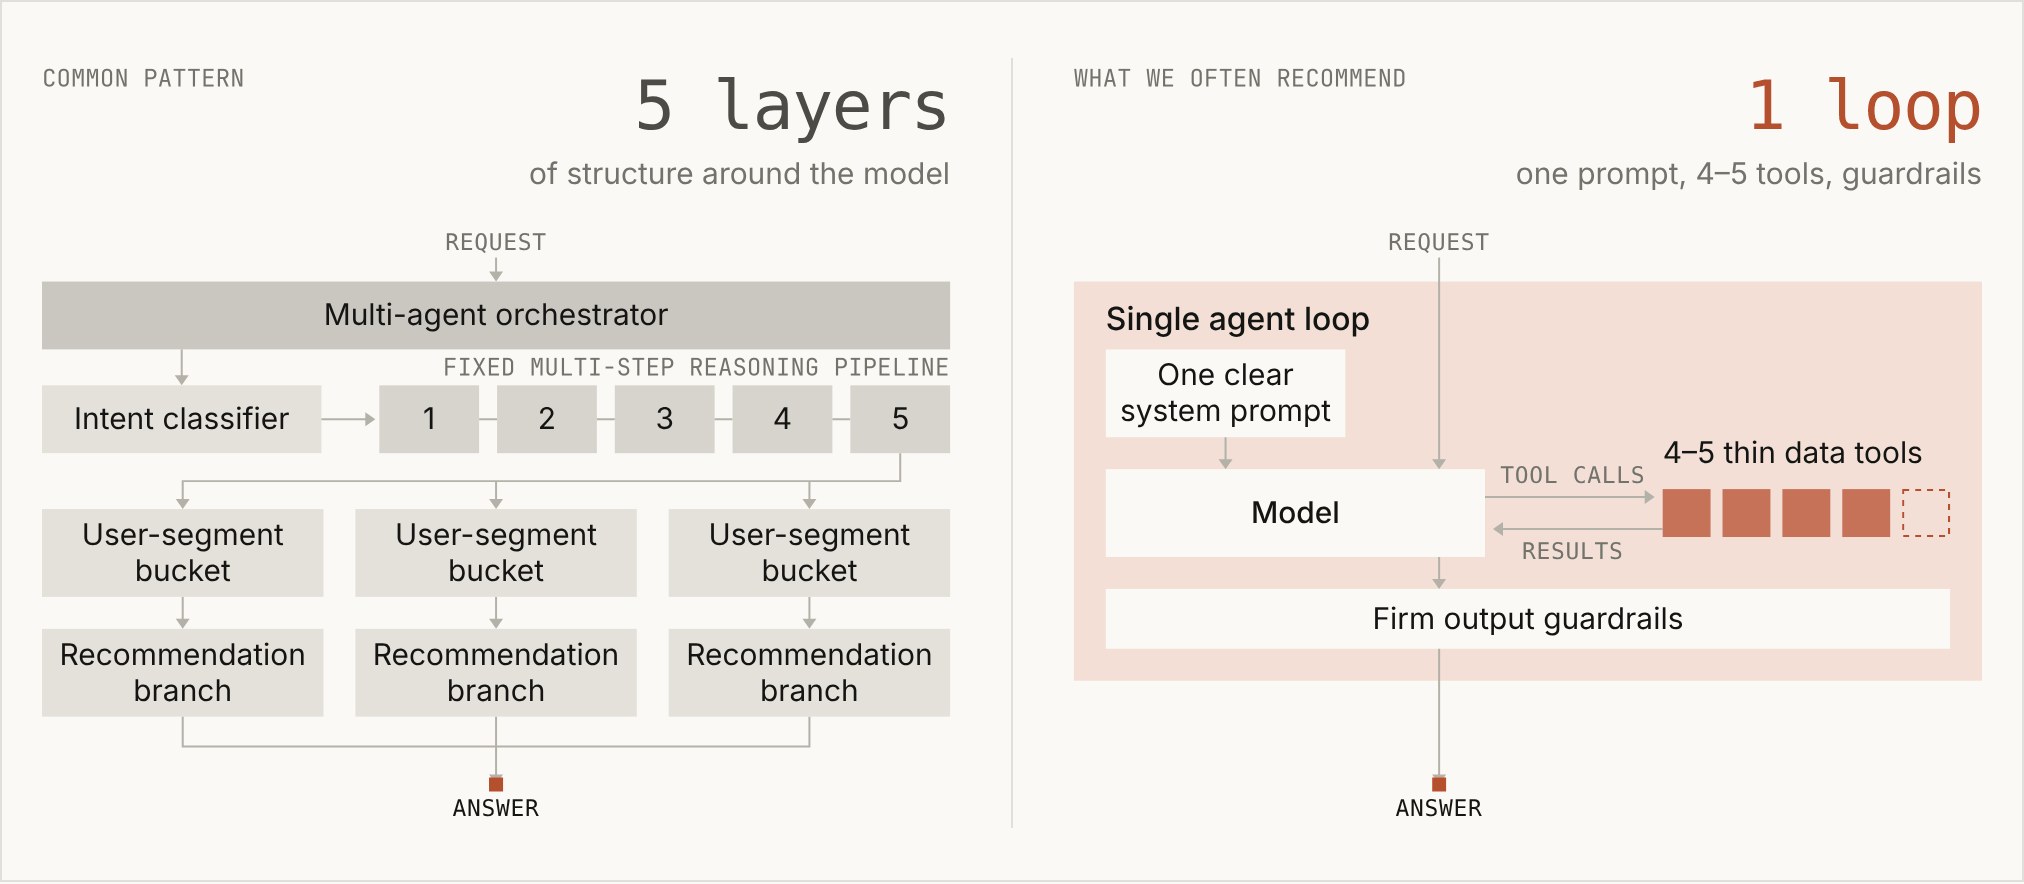
Anthropic 的 Applied AI 團隊整理了他們幫企業改 agent 的經驗,比過的幾個企業案例裡,單一 agent 的品質常常比較好,成本和延遲也比較低(原文)。
適合正在做企業 agent、手上已經有路由器加一排專家 subagent 的人,或是正要畫架構圖、想先切好幾個 agent 再說的人。原文是廠商自家的設計建議,案例沒點名公司、也沒公布樣本數,數字當參考看。
一、照組織圖切 agent,問題會一起搬進來
大公司常見的做法是讓每個產品團隊各做一個 agent,再由平台團隊在上面疊一個編排器。原文說這看起來最省事,實際上會把康威定律搬進 agent:架構長得跟組織圖一模一樣(原文)。
原文列的毛病有五個:agent 之間來回傳話會漏細節;每個團隊都上架自己的 subagent,最後幾百個重疊、沒人管;每個團隊都往系統 prompt 加一句,規則互相打架、語氣不一致,原文叫它 Frankenprompt;每個團隊只寫對自己子任務有利的 eval,主管看的是灌水的局部分數;多層架構本身就拖慢速度。
速度這點有個數字:有一家客戶拿自己的多 agent 系統跟單一 agent 迴圈比,後者跑起來大約快 2 倍(原文)。另一家公司的客服 agent 底下有十幾個專家 subagent,品牌語氣很難統一,延遲也拖累使用體驗。
原文還提到,他們常收到一種架構提案:意圖分類器、固定的多步推理管線、使用者分群、各自的推薦分支,最上面再加一個多 agent 編排器。收到的回饋通常是,這些結構大多在替模型做它已經不需要別人代勞的事,一份清楚的系統 prompt、4–5 個精簡的資料工具、嚴格的輸出護欄,就能涵蓋大部分用途(原文)。
二、一個迴圈加按需載入,比收摘要更準
原文推的替代方案是漸進揭露:agent 一開始只看到每個 skill 和工具的簡短說明,真的要用時才載入全文。skill 是一包寫好的做事步驟和規則,工具則透過 tool search 用到再查。
第一個理由是共享上下文。同一個 agent 看過前面每一步的原始結果,就能把它們串起來;一堆 subagent 各自交回摘要,每交接一次就漏一點(Claude:多 agent 系統何時用)。
第二個理由是上下文不會爆。以前團隊拆 subagent,主要就是怕一份系統 prompt 塞不下所有東西;改成按需載入,這個理由就沒了。原文舉自家例子:他們替較新的模型把 Claude Code 的系統 prompt 砍掉超過 80%,其中一部分就是把 skill 和工具改成按需載入(Claude 開發者部落格)。
第三個理由是模型變強了。原文說從 Opus 4.5 開始,模型在單一迴圈裡能處理的事遠超過多數團隊預期,新模型也會邊做邊回報進度、自己檢查,有些 harness 裡的機制就變多餘了。他們幫客戶換模型時,常常卡住新模型的正是死板的多 agent 結構(原文)。
三、subagent 該留的情況只有三種
原文沒有叫大家把 subagent 全拆掉。Anthropic 自己的多 agent 研究系統就在用,驗證、平行工作、分權限這幾件事 subagent 都做得好。
值得留的情況有三種(原文):
- 單一迴圈因為上下文太肥,表現可以量得出來地變差。
- 好幾件事要平行做,每件都要乾淨的上下文,做完就丟。
- 單一 agent 選不對工具,或系統 prompt 裡的指令互相衝突。
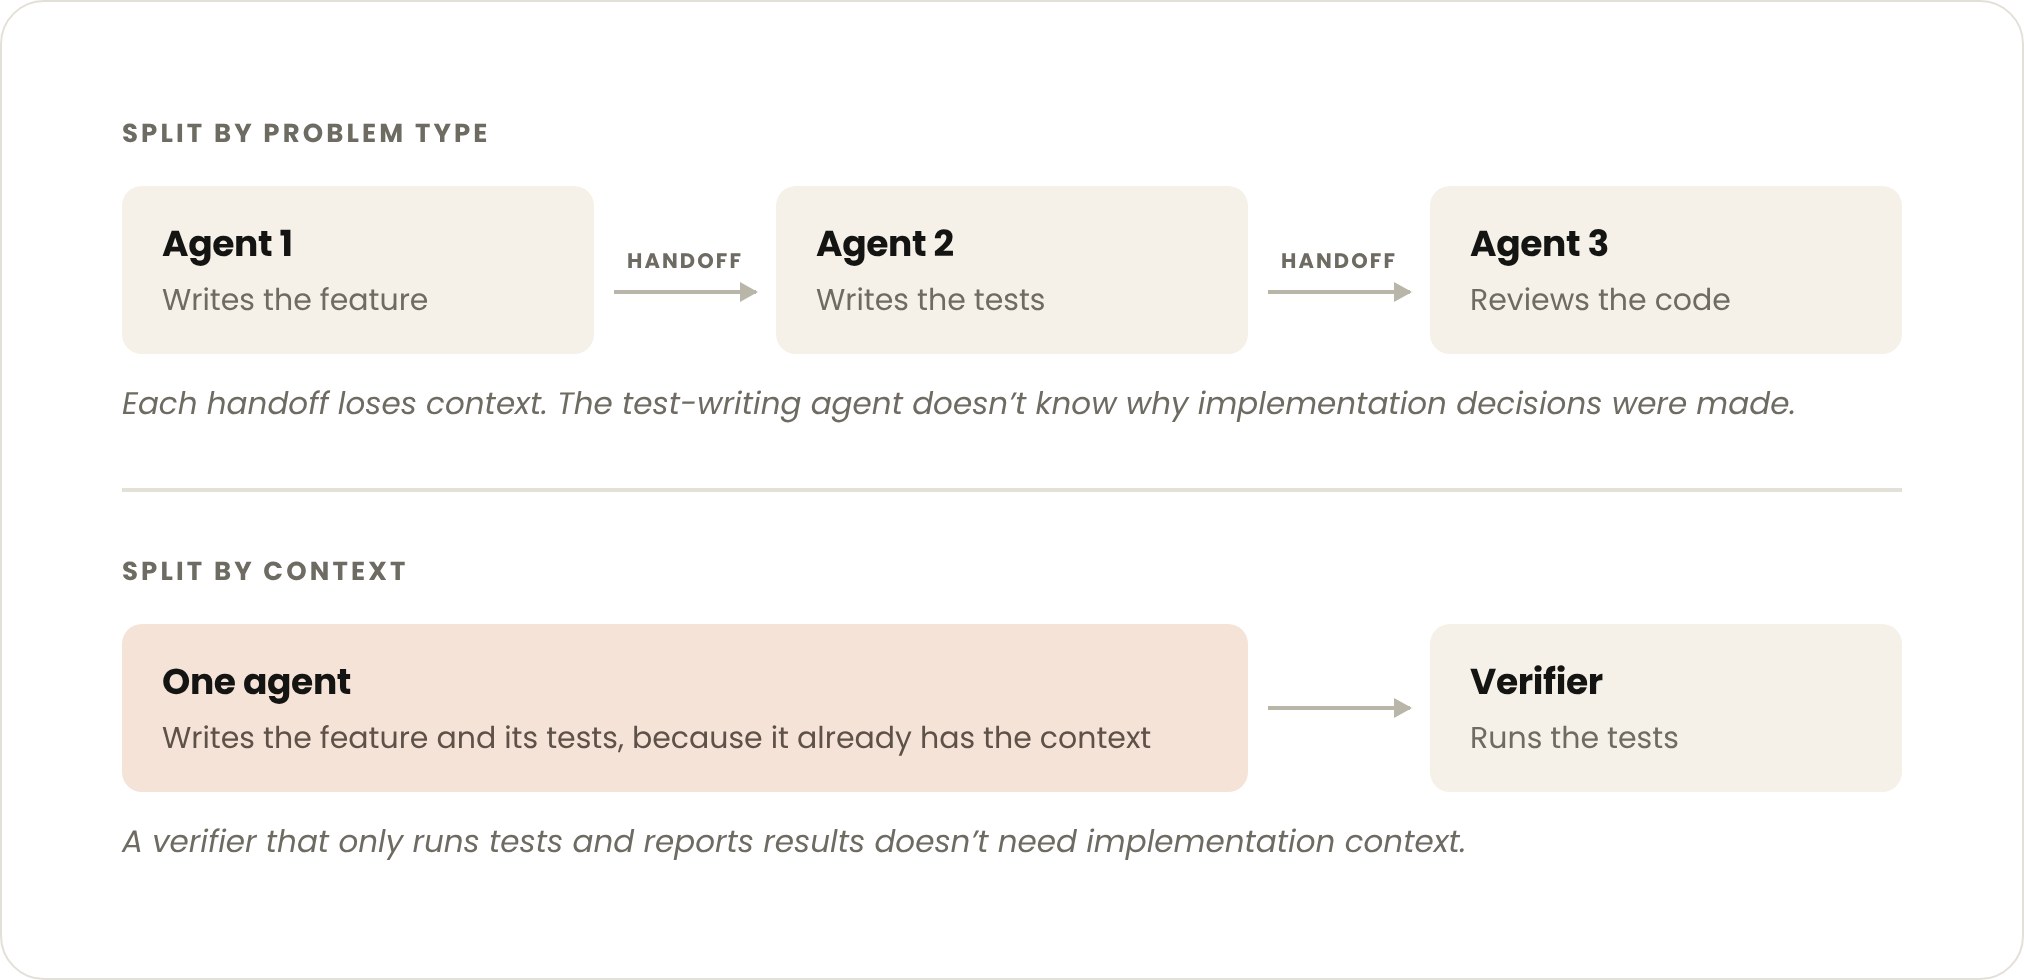
真的要拆,原文建議照上下文切,別照問題類型切。給每個 subagent 一塊幾乎不需要知道其他部分的工作,讓它交回精簡的結果,例如獨立的研究方向、介面乾淨的元件、黑箱驗證。照問題類型切的話,agent 之間就像在玩傳話遊戲,每傳一手失真一點。
四、寫計畫的模型,就是執行計畫的那個
原文建議的目標架構是一個模型、一個上下文視窗,跑一個開放式的工具迴圈。回合數、花費上限、寫入前要不要放行,這些限制設在 harness 裡(task budgets 文件)。
每一回合模型丟出一批工具呼叫,harness 平行執行,把原始結果交回同一個模型,由它決定下一步:再丟一批、回頭問使用者,或直接回答。模型回答或預算用完就停,回答後可以再跑一次目標檢查或驗證。
跟編排器加專家的架構比,最大的差別在計畫。模型第一回合就把計畫寫在上下文裡,結果回來再改;寫計畫的跟做事的是同一個模型,所以做到一半就能改計畫(原文)。
原本各處的東西也有新位置:步驟順序和領域流程放進 skill;驗證、核准關卡、對話中途才需要的東西(例如查記憶)放進工具;便宜又幾乎每次都用得到的東西(例如辨識使用者講的是哪個實體),還有組 payload、解析串流這類機械性工作,繼續用程式碼做,包在工具裡讓迴圈呼叫。
五、動架構前,先湊 10 題標準答案
要不要把某個 subagent 收回主迴圈,原文說第一步是先做 eval。他們看過有效的結構是:一套端到端的共用題庫由中央團隊管,每個 skill 再附一小組題目,由寫那個 skill 的團隊負責。起步只要 10 題標準答案就夠(原文)。
評分可以先從拿 rubric 檢查 agent 最後一則回覆開始。還有編排器時,順便看路由準不準,也就是有沒有派對 subagent;某個 subagent 收進來之後,改看 agent 有沒有載入對的 skill、叫對的工具。長期目標是看任務有沒有真的完成,比較架構時這個最重要。
內部系統很難重播、使用者行為很難模擬的環境,原文給的做法是在重要事件上記時間戳,之後拿來重播,當成針對性的 eval 跑。
- 挑 10 題真實請求寫成標準答案,當端到端 eval 的起點;還有編排器的話,順便記路由準確度。
六、一次收一個,盯著哪幾題翻盤
從多 agent 走到單一迴圈,原文給了三條路,可以分階段走(原文):
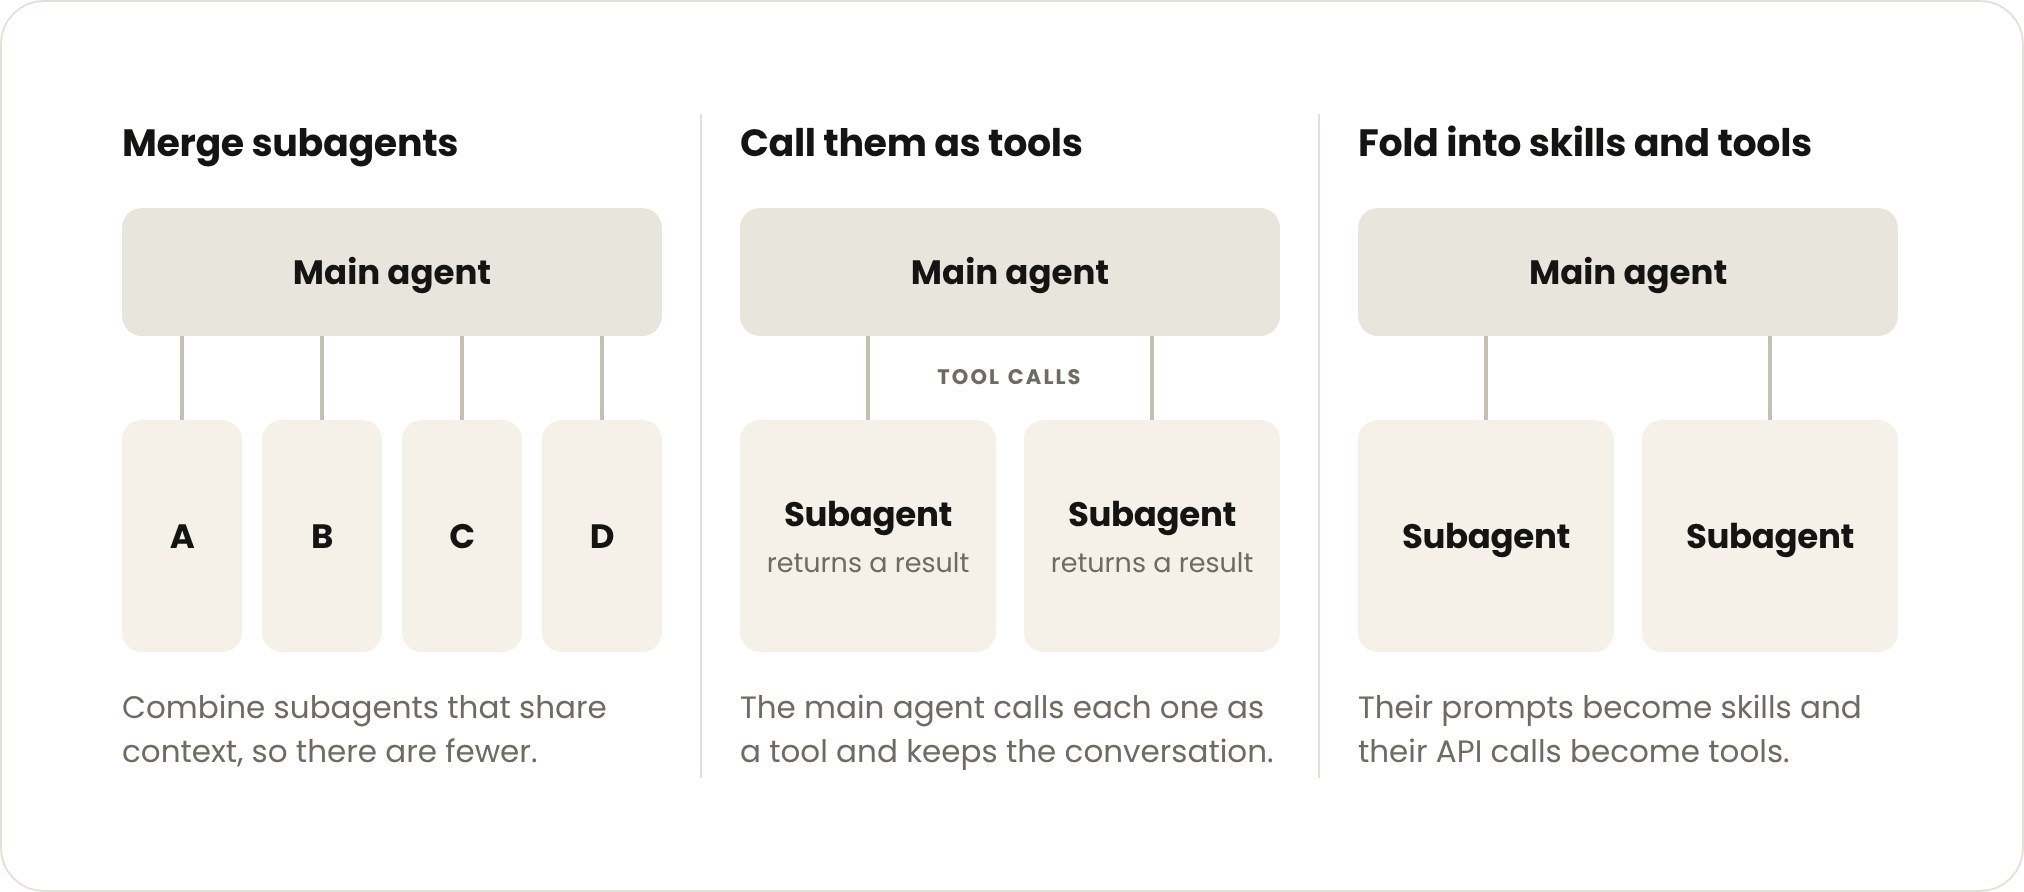
合併:先挑最常被用到的,把會吃彼此輸出、碰同一份資料、常一起被叫的專家併起來。如果正式流量裡有相當比例是 A 做完接 B,這兩個就是綁很緊的一對,可以併成一個領域 agent(Claude:多 agent 系統何時用)。
當工具呼叫:符合前面三種情況、決定保留的 subagent,讓主 agent 把它當工具叫,主 agent 繼續跟使用者講話。只有 subagent 必須直接跟使用者對話時,才整段交給它。這步不用重寫 subagent,還能先拿到一個 eval 基準;缺點是每個專家還是有自己的 prompt、團隊和 eval,每次呼叫還是交回有損的摘要,也還是多一層模型迴圈的延遲。
收進 skill 和工具:一次一個,把 subagent 的 prompt 改寫成 skill、API 呼叫改成 MCP 工具,跑 eval 比較有它和沒它的差別。比的時候別只看總分,要看哪幾題從過變不過。
原文自己就踩過:他們在一個範例客服 agent 上試,把一個 subagent 併進另一個,延遲降了,原本會過的流程卻壞了。主 agent 手上有查訂單的工具,就自己回答,沒去問負責出貨的專家送達日期。而且這個錯兩次只出現一次,所以原文建議每個任務都跑不只一次,正式環境裡每一條會一起跑的 agent 串、每一條不能破的規則,都要有對應的題目。
- 從 trace 找出常常 A 做完接 B 的 subagent 組合,先合併最常被用的那一對。
- 每次只收一個 subagent 進 skill 加工具,比較前後哪幾題翻盤,每題至少跑兩次。
- 確認每一條正式環境會一起跑的 agent 串、每一條不能破的規則,eval 裡都有題目。
七、各團隊改顧 skill 和工具,系統 prompt 交給一個小團隊
收成單一 agent 之後,其他團隊的工作換了位置。原文的分工是:各團隊從顧 agent 改成顧 skill、工具和知識庫,一個小的中央團隊顧系統 prompt 和端到端品質,新的 skill、工具、eval 上線前都要過它(原文)。中央團隊維持小規模,迭代快,大組織的協調成本也低。
MCP 工具適合要動手做事、讀即時資料、或要回固定格式結果的情況。原文建議照使用者意圖分組,別一支 API 一個工具,因為系統 prompt 裡的工具定義超過 30–50 個,選工具的準確度就會開始掉(原文)。
前置條件和權限也放進工具。例如 Y 需要 X 的結果,Y 的工具自己檢查,缺了就回一句模型看得懂的指示;每個工具自己檢查呼叫的使用者能看什麼、做什麼,不行就回一句清楚的拒絕。這樣一個迴圈就能服務不同權限的使用者,不用每個權限等級各做一個 agent。
skill 裝的是團隊怎麼做事:步驟、規則、判斷,也就是以前專家 subagent 的 prompt 在裝的東西。為了避免 skill 也氾濫,原文建議每個團隊指定負責人,確保 skill 寫得好、彼此不重疊、附 eval。知識庫則放偶爾才用得到的參考資料,像政策、指標定義、產品規格,放在搜尋或查詢工具後面讓模型自己查,別用程式碼抓來直接貼進 prompt(Claude:Seeing like an agent)。
- 把工具照使用者意圖分組,數一下系統 prompt 裡的工具定義有沒有超過 30–50 個。
八、這些數字都是 Anthropic 自己講的
- 這是 Anthropic 推自家平台的文章,結尾推的是自家 migration kit 和
/claude-api系列 skill。 - 「單一 agent 品質常常比較好、成本延遲常常比較低」,原文沒給分數、案例數或比較條件;「快約 2 倍」只來自一家沒點名的客戶。
- 「4–5 個資料工具就夠」「超過 30–50 個工具選擇會變差」是原文的經驗值,沒附測試資料。
- 原文自己的範例就顯示,收掉 subagent 可能讓延遲變好、正確率變差,而且錯誤不一定每次都出現。
九、明天就能做的事
以下都是原文自己給的步驟:
- 挑 10 題真實請求寫成標準答案,當端到端 eval 的起點;還有編排器的話,順便記路由準確度。
- 從 trace 找出常常 A 做完接 B 的 subagent 組合,先合併最常被用的那一對。
- 每次只收一個 subagent 進 skill 加工具,比較前後哪幾題翻盤,每題至少跑兩次。
- 確認每一條正式環境會一起跑的 agent 串、每一條不能破的規則,eval 裡都有題目。
- 把工具照使用者意圖分組,數一下系統 prompt 裡的工具定義有沒有超過 30–50 個。
- 想照原文的流程跑一遍,可以試 Anthropic 的 single-agent-loop-kit,裡面有模擬系統可以先練;
/claude-api指令的 build-eval、prompt-audit、hillclimb、cost-optimize 分別對應建題庫、找出為舊模型寫的規則、反覆調 skill 描述、找省錢的地方。
※ 資料來源:
- Building agents: When to fold subagents into your main agent loop,Diane Sarkis,Claude by Anthropic,2026-10-22(本文主要來源,三張圖出自此文)
- anthropics/single-agent-loop-kit,Anthropic,GitHub,2026
- Multi-agent coordination patterns,Claude by Anthropic,2026
- How we built our multi-agent research system,Anthropic Engineering
- The anatomy of effective commerce agents,Claude by Anthropic,2026(企業部署比較的出處)
- Building agents with skills: equipping agents for specialized work,Claude by Anthropic,2026
- Building multi-agent systems: when and how to use them,Claude by Anthropic,2026
- The new rules of context engineering for Claude 5 generation models,Claude 開發者部落格,2026(Claude Code 系統 prompt 減少超過 80%)
- Task budgets,Claude Platform 文件
- Tool search tool,Claude Platform 文件
- Seeing like an agent,Claude by Anthropic,2026
- Claude Code commands,Claude Code 文件
※ 非官方圖文整理。數字和案例全部出自原文與原文連結,沒有另外查證;英文引文為原文,中文為我們的翻譯。三張圖出自原文。