[情報] Credit Karma 怎麼讓每個 agent 上線就帶齊閘道、追蹤和遮罩:同一題 token 從 2.4 萬降到 2,400
適合在公司裡負責 AI 平台、或正要把第一批 agent 推上正式環境的工程師。講者的環境是受監管的金融科技公司,有些網路是隔離的。〔0:03〕
- agent 上線出事,多半是缺底層,不是模型不夠聰明
- 註冊 agent 的那一刻,就把 repo、身分和資料表一起建好
- 從本機到上線走同一條路:PR 兩人核准、掃映像、進 Kubernetes
- 所有工具呼叫都要先過 MCP 閘道,不准直連
- 閘道的 log、trace 和指標分三條線收
- 寫入和敏感操作要等人核准,讀取直接跑,兩種都留稽核
- 每次查詢都記 thread、run 和 checkpoint,追問才接得上
- 每個 agent 從第一天就記成本和品質,半年後才答得出 ROI
- 敏感資料在打字的當下就遮掉,不進模型也不進 log
- context 最佳化讓同一題 token 從 2.4 萬降到 2,400
- 明天就能做的事
- 資料來源
一、agent 上線出事,多半是缺底層,不是模型不夠聰明
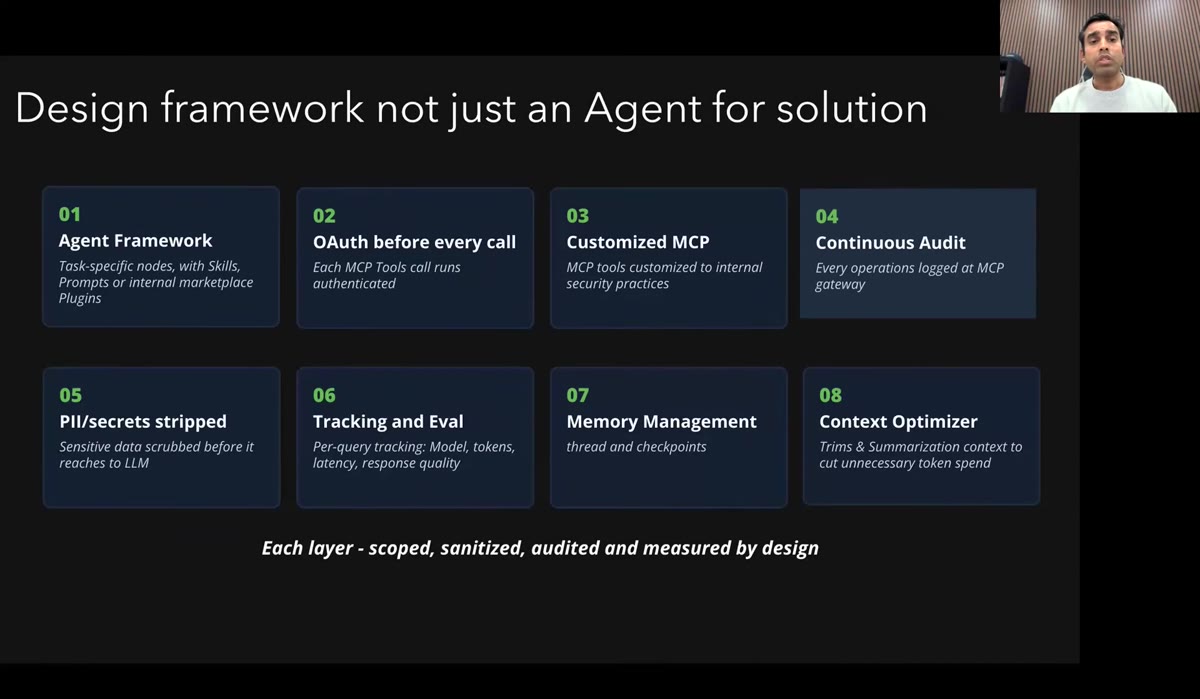
Harish Gaggar 是 Intuit Credit Karma 的資深主任工程師,負責 AI 分析的基礎設施。他列出 agent 進正式環境常缺的東西:沒有閘道先驗證身分再轉到對的 MCP 伺服器、MCP 伺服器沒有合適的工具、沒有追蹤和評估、沒有記憶、沒有省 token 的機制、也沒有擋住密鑰外流的關卡。〔0:03〕 〔1:07〕
所以他不打算做一個「神奇的 agent」,而是做一組每個 agent 都要套上的框架:LangGraph 寫 agent 本體、MCP 閘道、自建 MCP 伺服器、稽核,再加上敏感資料遮罩、追蹤評估、記憶和 context 最佳化。〔2:09〕 〔3:12〕
二、註冊 agent 的那一刻,就把 repo、身分和資料表一起建好
流程從註冊開始:先在系統登記用途、拿到 agent ID,再到內部開發入口填框架(LangGraph 或 LangChain)、語言(Python 或 TypeScript)、要用的技能和 prompt。〔4:14〕
入口產生的 repo 不只有 agent 程式,也已經放好記憶、追蹤評估、context 最佳化和敏感資料遮罩的框架。他的理由是開發者不一定會顧到每一塊,集中做才會全公司一致,結果也能放在同一處看。〔5:18〕
同時建好的還有正式環境資源:workload identity、記憶資料庫、追蹤評估資料表、密鑰管理。部署時 agent 已經知道自己綁哪個身分,直接就能連 AI 閘道、MCP 伺服器和 Langfuse 追蹤。〔7:22〕
- 新 agent 的範本 repo 裡先放好追蹤、記憶和遮罩,別讓每個團隊各寫一套。
三、從本機到上線走同一條路:PR 兩人核准、掃映像、進 Kubernetes
開發者 clone repo、在本機用 Docker 跑 agent,追蹤評估先存在 SQLite 或 BigQuery,確認能動再開 PR。拿到兩個核准後進 CI/CD:先把 agent 登記到中央的 agent 註冊系統,再建正式映像、掃弱點,資安通過後推回映像庫,最後由內部部署平台佈到 Kubernetes 指定的 namespace。〔6:32〕 〔7:00〕
四、所有工具呼叫都要先過 MCP 閘道,不准直連
在隔離網路(air-gapped)環境,他建議自建 MCP 伺服器,可以用 FastMCP 包裝。每個工具都要先經內部資安審查,才能上正式環境,藉此限制欄位、擋掉不該送給 LLM 的資料。〔8:25〕
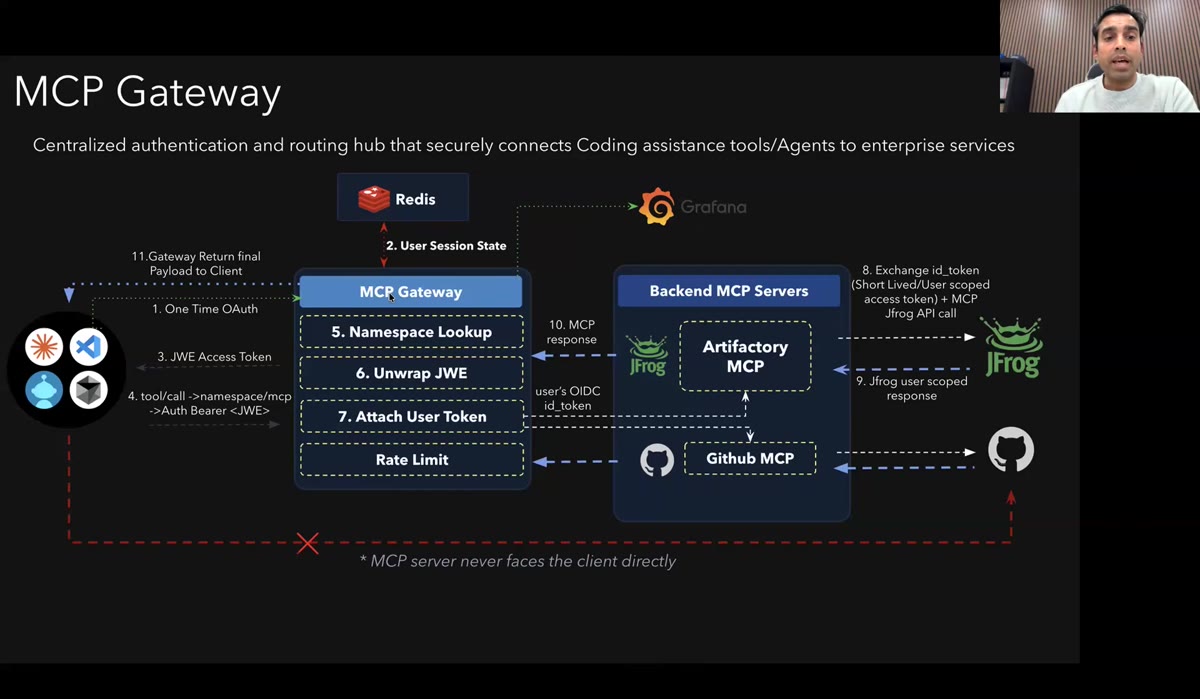
閘道的流程:第一次查詢時 client 向閘道驗證,閘道把 session 存進 Redis、回傳 JWT;之後 client 帶著 JWT 呼叫某個 namespace 的 MCP,例如 Artifactory 或 GitHub;閘道查 namespace、解開 JWT、附上使用者 token 轉給 MCP 伺服器,伺服器只回這個使用者有權看的資料。〔9:47〕 〔10:31〕
他的原則是端點不開直連,不管是寫程式的 AI 助理還是 agent,都要經閘道驗證再到 MCP 伺服器。他把這套做成可以在本機用 Docker 跑的參考實作放在 GitHub。〔11:35〕
五、閘道的 log、trace 和指標分三條線收
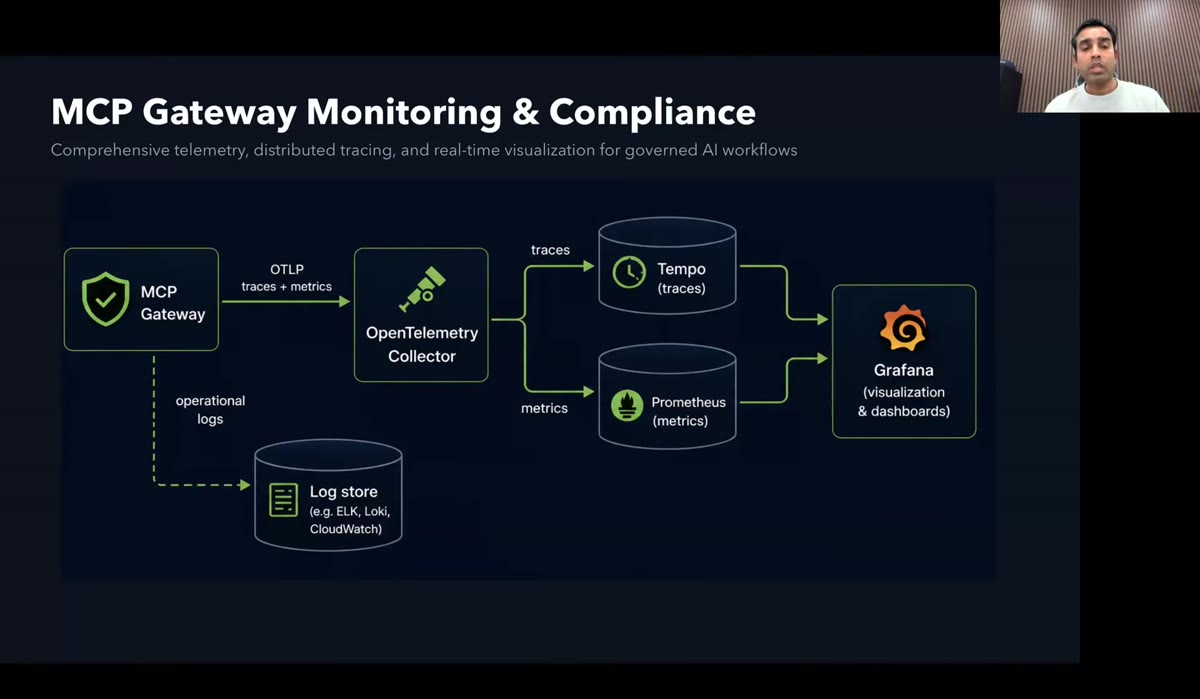
操作 log 進 ELK、Loki 或 CloudWatch,回答「最近 10 分鐘有哪些 401」「token 更新失敗時 OAuth 做了什麼」這類問題。trace 和指標經 OpenTelemetry 收集:trace 存 Tempo,看哪個工具慢、呼叫來自 agent 還是 IDE、失敗的確切錯誤;指標存 Prometheus,看各工具的 P95 延遲、授權拒絕有沒有暴增。最後在 Grafana 畫成儀表板。〔11:48〕 〔12:37〕 〔13:42〕
六、寫入和敏感操作要等人核准,讀取直接跑,兩種都留稽核
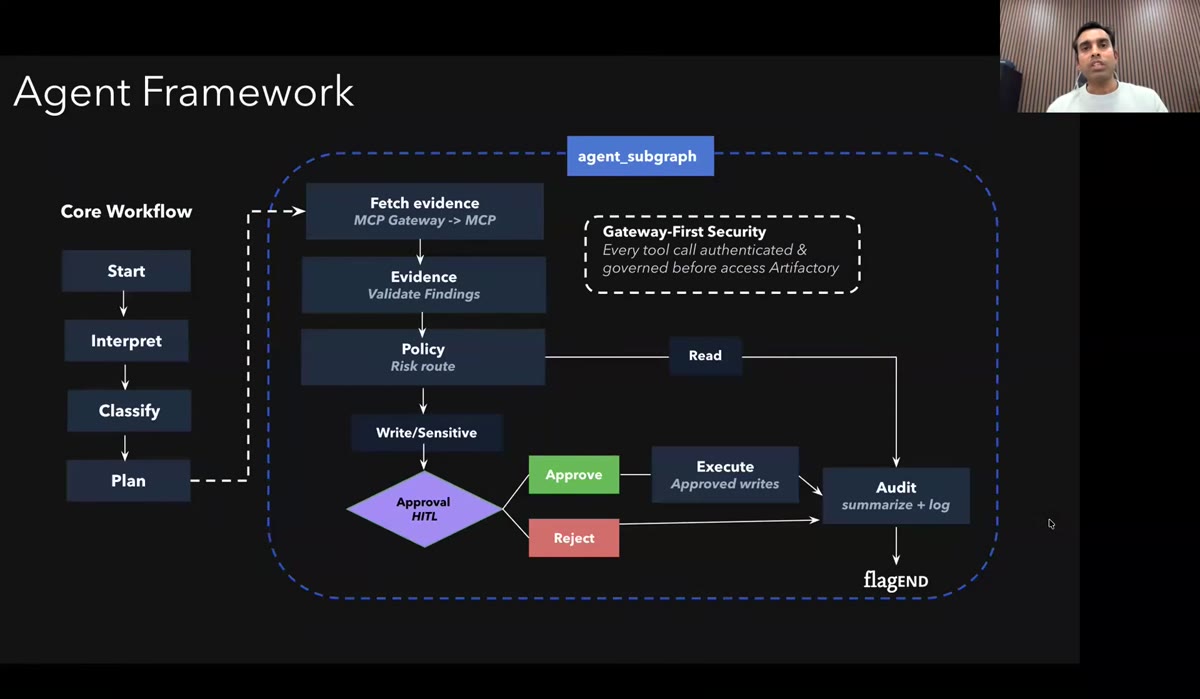
agent 用 LangGraph 寫:先理解問題、分類這是讀取、修改還是刪除這類敏感操作,再規劃。規劃本身是一個子圖:經閘道驗證、呼叫 MCP 工具拿資料、整理成證據,再檢查政策。〔14:01〕 〔14:45〕
唯讀的直接執行、寫進稽核紀錄;寫入或敏感操作走人工核准,核准就執行,被拒也一樣記進稽核紀錄。〔15:46〕
- 把 agent 的動作先分成讀和寫,寫的那條路一定要經過人。
七、每次查詢都記 thread、run 和 checkpoint,追問才接得上
記憶的做法:每段對話是一個 thread,每次提問產生一個 run ID,執行到 LangGraph 的哪個節點就在那裡存 checkpoint;追問會在同一個 thread 產生新的 run。本機用 SQLite,正式環境在 GCP 用 Cloud Spanner,Azure 和 AWS 用各自的資料庫。〔16:59〕 〔17:55〕
他示範直接查記憶資料庫:看得到 thread ID、問題和時間、叫了哪些工具、LangGraph 走過哪些節點。〔18:00〕 〔18:58〕
八、每個 agent 從第一天就記成本和品質,半年後才答得出 ROI
這裡記的是 agent 層級的資料,和閘道監控分開:問了什麼、回了什麼、用哪個模型、花多少 token、品質評分。他說如果有 100 個 agent,就有 100 組追蹤評估表,半年後有人問表現如何、燒了多少 token,才能匯總做成主管看的 ROI 儀表板。〔19:48〕 〔20:00〕
示範裡有六張表:工作追蹤、品質、評分、品質指標、工具呼叫、agent 軌跡。每次執行跑八項品質檢查,包括成功、延遲、成本、工具準確度、安全;評分表把各面向收成一列 0 到 1 的分數。〔21:15〕 〔22:17〕
影片說明也提醒,示範是在看這些紀錄長什麼樣,沒有證明整個系統的品質分數。影片說明
九、敏感資料在打字的當下就遮掉,不進模型也不進 log
使用者可能上傳含敏感資訊的文件,或不小心貼了 API key。他們定義資料類型和嚴重度,嚴重度高於 90% 的就立刻擋下、遮蔽,不送進 LLM,也不進記憶庫、追蹤評估表和 trace 系統。〔23:11〕 〔23:56〕
影片說明補充,偵測和遮蔽是要持續評估的控制措施,不保證密鑰一定漏不出去。影片說明
十、context 最佳化讓同一題 token 從 2.4 萬降到 2,400
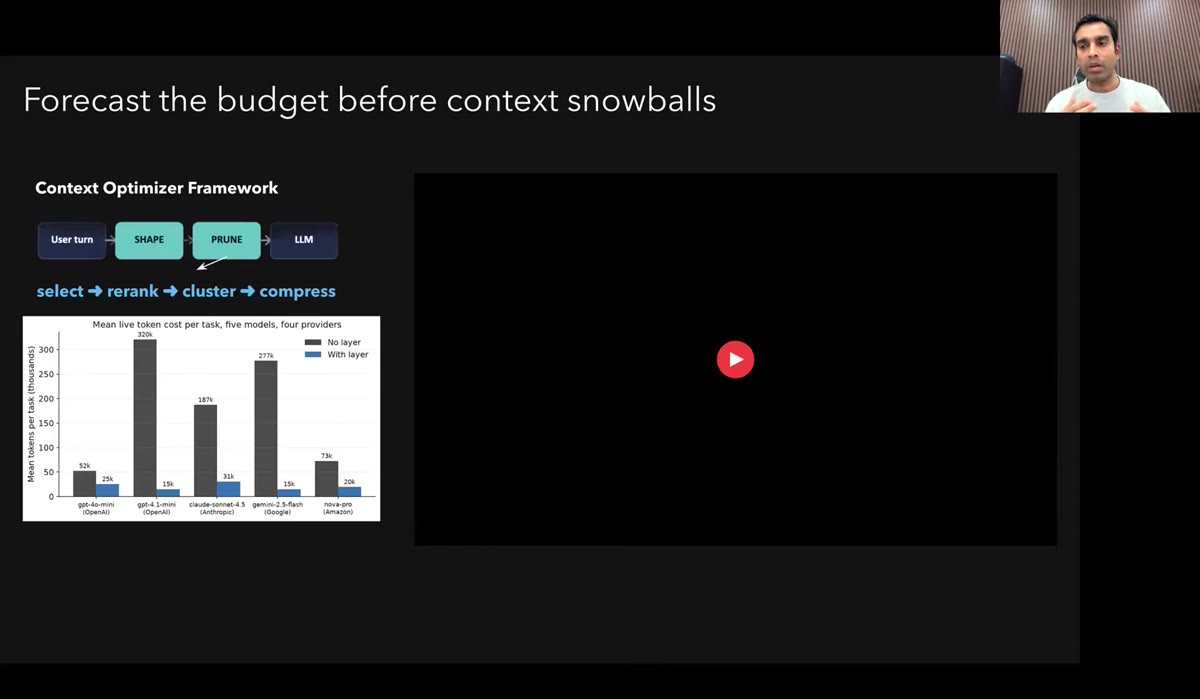
送進 LLM 前先修剪:依 token 上限挑資料、重新排序、去重,最後壓縮。〔24:25〕
示範問「列出我 JFrog Artifactory 裡所有 artifact」,第一次用了約 24,000 token;開啟最佳化後同一題約 2,400,他說省了約 90%。Slack bot 問 Docker 映像也是從約 24,000 降到約 1,500。他說多數情況省 70% 到 78%。〔25:57〕 〔26:22〕 〔27:08〕
影片說明提醒,這些示範沒有對照回答品質有沒有變差,也沒有量測商業上的 ROI。影片說明
明天就能做的事
資料來源
- Paving the Road to Production: Governed Enterprise AI Agents — Harish Gaggar, Credit Karma(原始影片)|AI Engineer(YouTube)|2026
- harish-gaggar/mcp-server-gateway|Harish Gaggar(GitHub)|2026
- Building an OAuth-Secured MCP Gateway for Enterprise Agents|DEV Community|2026
- 講者介紹|eVidya Foundation|影片說明附的連結
※ 使用者提供的是影片檔,依投影片標題找到 AI Engineer 頻道上的原片(長度相同)。逐字稿以 Whisper(medium.en)轉寫影片原音,對照原片的 en-orig 字幕校正。圖片截自原片。〔時間〕連結開啟原片對應段落。token 和百分比是講者示範時的數字,沒有另外查證。講者的書 MCP for the Enterprise 在片尾提到,說明欄沒附連結所以不列。本文為非官方整理,以原影片為準。